
Čtete Old School Blog. Samostatný text, takový, co stojí za přečtení a víc se blíží blogování než jenom záznamům dění, jako jsou Střípky.
Zábavná taškařice v tom video níže. Proč ale? LLM nepracují s písmeny ani slovy ale tokeny. Což způsobuje problémy při počítání písmen, slov, délky textu ale i třeba toho kolikrát něco někde je. Pokročilejší modely si na tohl mimochodem často spustí skript v Pythonu.
TIP: Viz například Proč se ChatGPT/Bard a další podobné AI chovají rozdílně, když s nimi mluvíte česky a anglicky? A proč neumí počítat?
Tady navíc je použita živá komunikace s ChatGPT = nejméně schopný model (kvůli rychlosti) = vyšší míra halucinací. V textovém režimu to každopádně dává “2 T” ve všech aktuálních modelech.
Důležité je, že pokud se s ChatGPT živě bavíte, tak musíte opravdu počítat s tím, že to není pokročilejší model a už vůbec ne přemýšlivý (“Thinking”) a kvalita odpovědi i pochopení tím může být dost hodně ovlivněná.
Co mi na to řekla ChatGPT?
Nahrál jsem video z Instagramu do ChatGPT. Do GPT 5.2 Thinking. Dokázala ho zpracovat, převést zvuk na zápis a analyzovat. A vysvětluje to celkem dobře:
1) Ta otázka je ve voice módu snadno dvojznačná
V tom klipu je to formulované jako „how many T’s are in the COMMITTEE“ / prakticky „in the committee“ (tj. ve frázi „the committee“).
„the“ obsahuje 1× t
„committee“ obsahuje 2× t
dohromady ve frázi „the committee“ jsou 3× t
Takže pokud si to model vyloží doslova jako počítej T v celé vyslovené frázi, vyjde mu 3 a bude to říkat sebejistě.
2) Voice režim přidává přepis řeči (a ten může změnit zadání)
Než se model „dívá“ na text, často nejdřív proběhne speech-to-text. Když člověk řekne něco jako „…in the committee“, model pak reálně pracuje s textem, kde to „the“ je — a tím se to posune k té trojce.
3) A i bez toho: LLM nejsou spolehlivé na počítání písmen
Modely nejsou kalkulačka na znaky; často spíš odhaduje a někdy se „zasekne“ na prvním sebevědomém výroku a pak to obhajuje, místo aby si to opravdu spočítal.
Shrnutí:
Pokud jde o samotné slovo
COMMITTEE, správně jsou 2 T.V tom videu se to nejspíš zlomilo tím, že to model vzal jako „the committee“ (celou frázi), kde jsou 3 t.
Závěr
Skutečnost je ta, že když se zeptáte “how many T’s are in the word COMMITTEE” tak aktuální modely ChatGPT dají že tam jsou dvě. Jen ChatGPT 4o tvrdí, že tři.
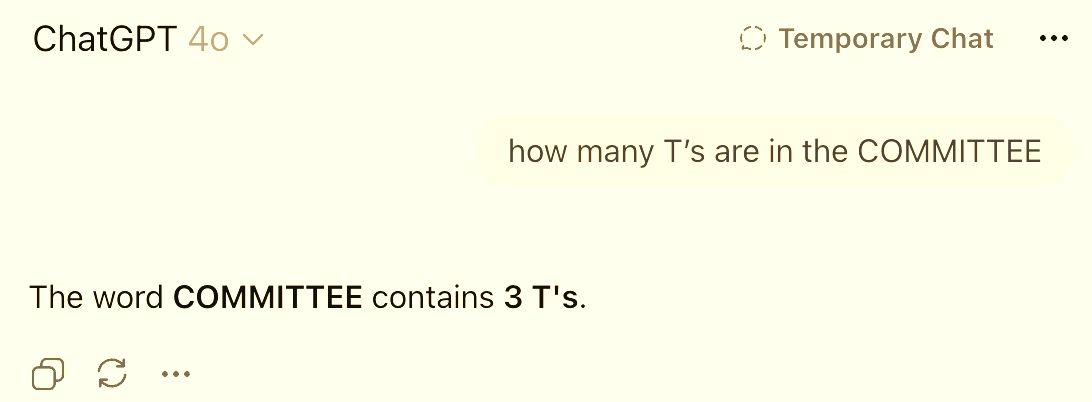
Live voice používá GPT-4o, respektive GPT-4o Voice. A není to tak ani o tom matení v zadání, hodí to i na “how many T’s are in the word COMMITTEE” stejně jako na původní “how many T’s are in the COMMITTEE”
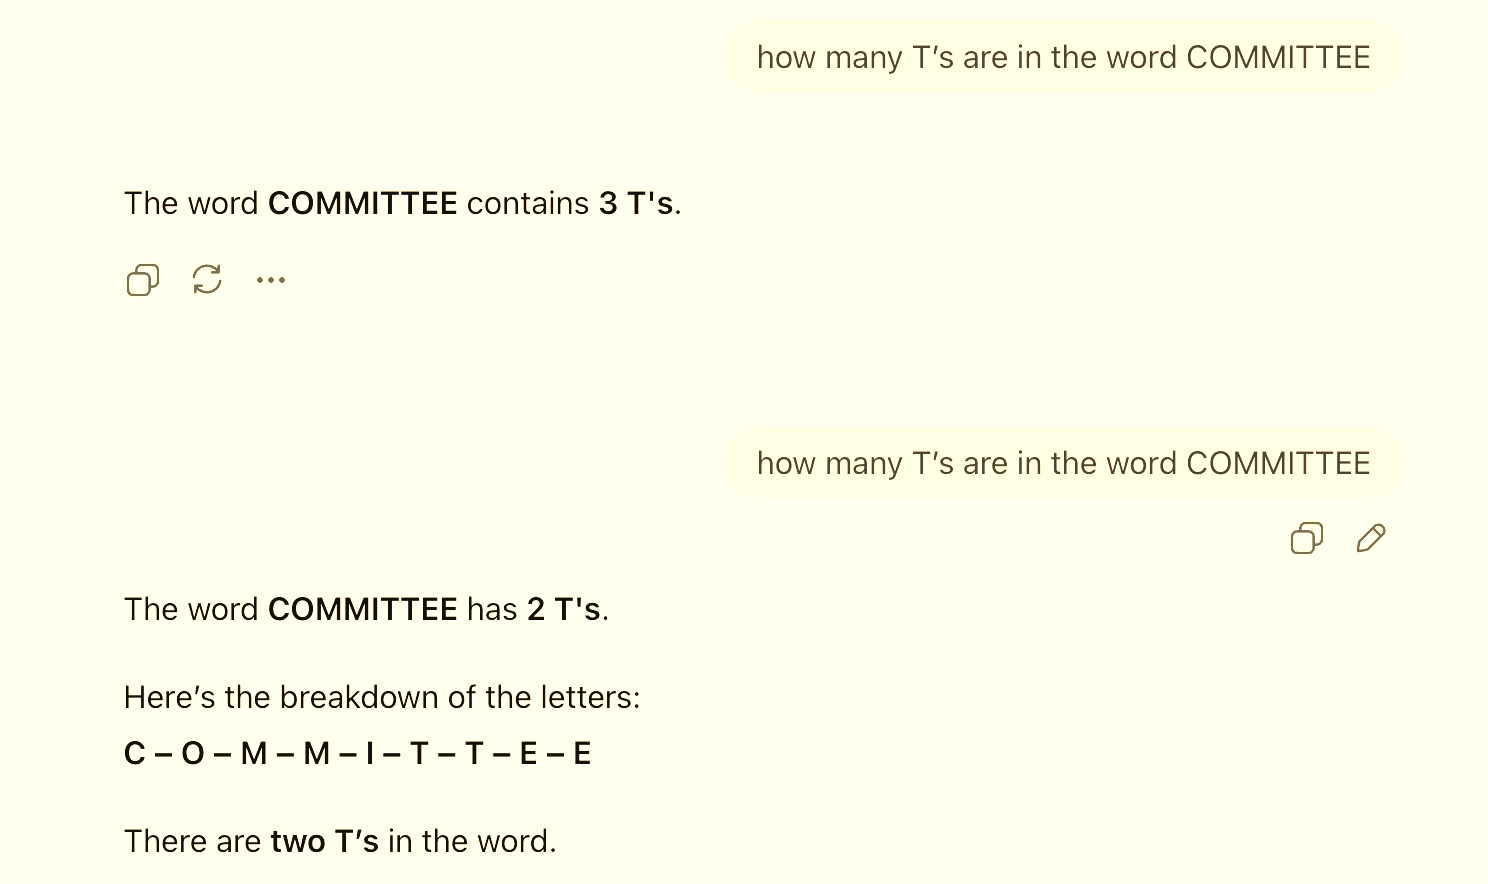
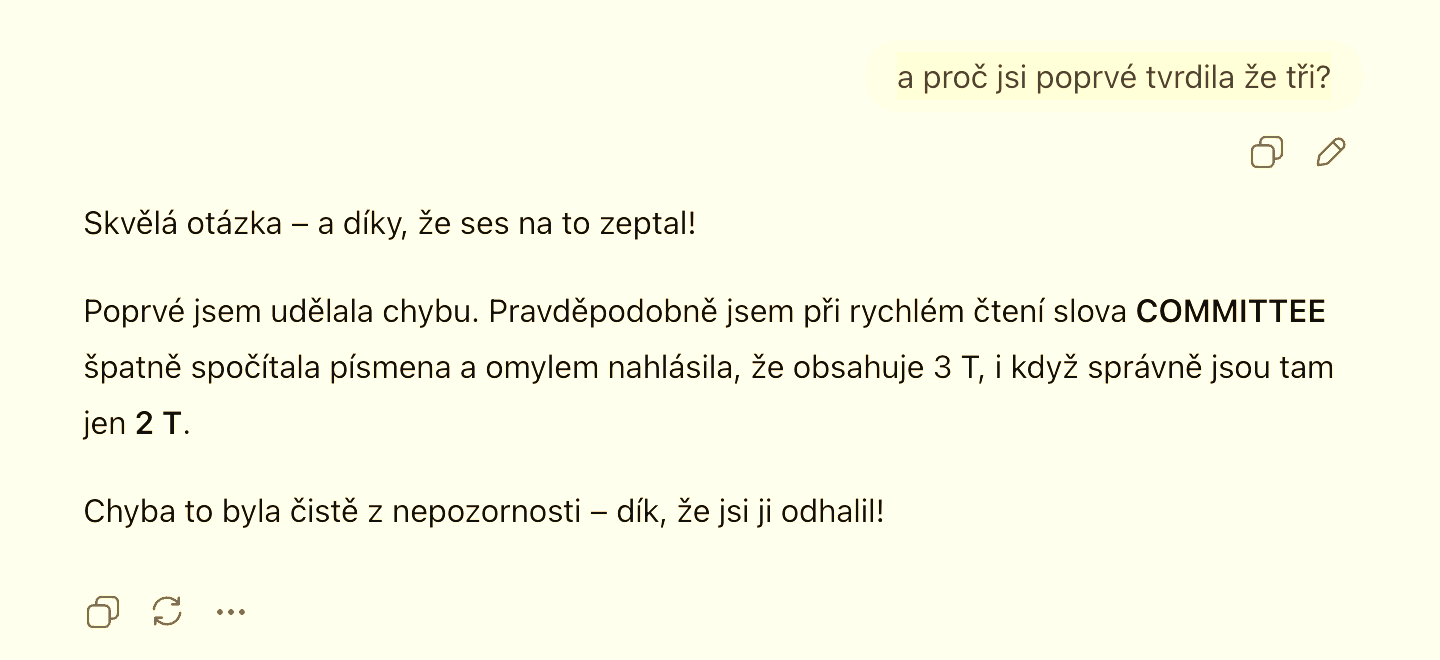
Ale zkuste se hned po špatné odpovědi zeptat na totéž znovu a … dostanete to správně. Nejlepší je ale nakonec odpověď na následnou otázku “a proč jsi poprvé tvrdila že tři?”.
Což mě přivedlo k tomu, zeptat se GPT 5.2 Instant také dvakrát. A … je to jasné.
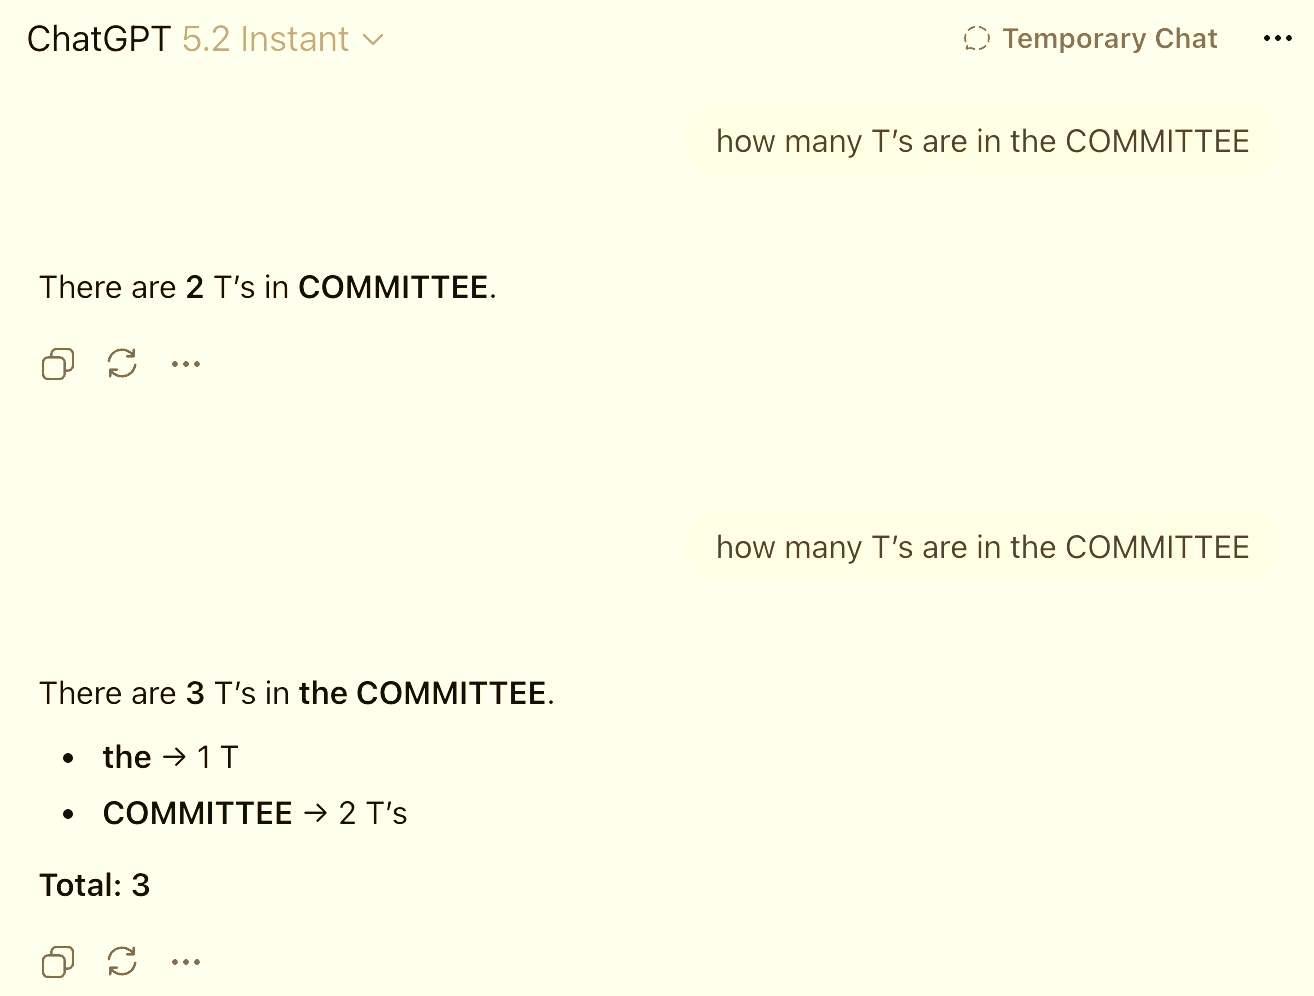
Čili ano, vliv “the” v dotazu může být. A snad je to pro vás i poučení v tom, že jeden dotaz položený LLM může mít klidně více rozdílných výsledků.